推测解码为什么能加速推理
大模型逐个生成 token,小模型先起草一段,大模型一次检查这段草稿——推测解码利用的是“验证一段候选”与“从零逐个生成”的成本差。草稿只有通过接受规则才会进入输出;速度收益取决于候选命中率和验证开销,不能仅看两个模型的参数量。
一次验证为什么能推进多个 token?
普通自回归生成中,下一个 token 还没确定,后续位置的输入也就没确定。推测解码先让便宜的草稿模型按顺序生成候选,目标模型便有了一段已知输入,可以在一次前向计算中评估多个位置的条件分布。它并没有消除因果依赖,而是先猜一条路径,再核验这条路径。
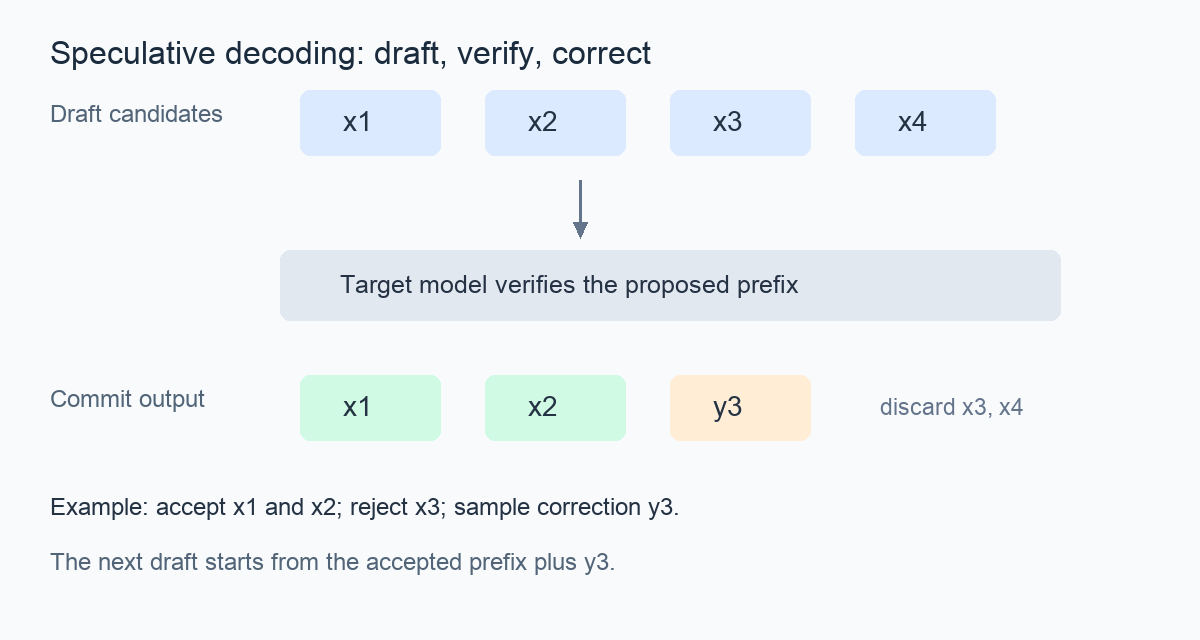
接受只能沿前缀推进。第三个候选没通过,第四个候选就不能单独保留,因为它原来依赖包含第三个候选的上下文。下一轮从已经接受的前缀及修正 token 继续;若整段都通过,经典算法还可从目标模型分布多采样一个 token。原始论文算法 1给出了这一步的完整定义。
“输出不变”指的是哪一种不变?
贪心解码可以逐位置比较候选与目标模型的选择,保留连续匹配前缀。随机采样则不能简单要求“两个模型抽到同一个 token”:那样会改变最终概率。经典推测采样使用接受概率与拒绝后的校正分布,在精确概率及正确实现的前提下,保留目标采样分布。
分布相同不意味着每次调用得到同一句话,也不保证相同随机种子在不同实现中走相同随机数序列。浮点计算、采样配置和实现细节也可能影响实际结果。比较输出时,应先明确是在检查贪心序列一致性,还是随机采样的分布性质。
用三个候选看懂接受规则
固定一个前缀,把目标模型分布记为 p,草稿分布记为 q。候选 x 从 q 中抽取,接受概率为 min(1, p(x) / q(x));被抽到的候选必有 q(x) > 0。若拒绝,则从与 max(p(x) − q(x), 0) 成比例的分布重新抽样。这里的 p、q 应是与实际采样设置一致的分布,而不是随意取出的原始 logits。
| 候选 | 目标 p | 草稿 q | 接受概率 | 接受后的概率质量 |
|---|---|---|---|---|
| A | 0.6 | 0.2 | 1 | 0.2 |
| B | 0.3 | 0.5 | 0.6 | 0.3 |
| C | 0.1 | 0.3 | 1/3 | 0.1 |
接受部分是 q(x) × min(1, p(x) / q(x)) = min(p(x), q(x)),总和为 0.6。剩下 0.4 的拒绝概率通过校正补回去:本例正差只有 A 的 0.4,所以拒绝后必选 A。最后 A、B、C 的总概率恰好是 0.6、0.3、0.1。
这不是凭直觉认定“小模型够准确”。对每个候选,接受贡献 min(p, q),校正贡献 max(p − q, 0),两者相加等于 p。这个单步恒等式解释了为什么校正不可省略;完整序列还需逐条件前缀正确执行算法。
from fractions import Fraction as F

def check(p, q):
    accepted = [min(a, b) for a, b in zip(p, q)]
    residual = [max(a - b, F(0)) for a, b in zip(p, q)]
    rejection = 1 - sum(accepted)
    assert rejection == sum(residual)
    if rejection:
        corrected = [x / rejection for x in residual]
        output = [a + rejection * r for a, r in zip(accepted, corrected)]
    else:
        output = accepted
    assert output == p
    return accepted, rejection, output

p = [F(6, 10), F(3, 10), F(1, 10)]
q = [F(2, 10), F(5, 10), F(3, 10)]
a, r, out = check(p, q)
check(p, p)
check([F(1), F(0)], [F(0), F(1)])
print('accepted mass:', [float(x) for x in a])
print('rejection probability:', float(r))
print('final distribution:', [float(x) for x in out])
示例使用标准库分数做精确计算,已运行并验证 p = q 及支持集合完全不重叠的边界。输出为:
accepted mass: [0.2, 0.3, 0.1]
rejection probability: 0.4
final distribution: [0.6, 0.3, 0.1]
它检验单步概率质量,不调用真实模型、不生成完整序列,也不测 GPU 性能。p = q 时没有拒绝,代码避免了对零概率校正分布做归一化。
草稿越长,未必越快
猜得长,可能一次接受更多 token;但草稿生成本身有成本,第一次拒绝后的候选也会浪费。目标模型验证长候选的代价同样不是常数。动态推测长度尝试根据当前情况决定何时停止起草,而不是每轮固定猜很多。
Hugging Face 在 2024 年 10 月 8 日的动态推测介绍中说明了利用草稿置信度停止起草的方案,并报告 RTX 4090、特定模型组合和任务下的评测。那些属于作者自报的实验,本文没有复现,也不引用最大倍数作为部署承诺。
一个简化的判断式是:一轮的草稿、验证和管理耗时之和,除以本轮实际提交的 token 数,是否低于普通解码的平均每 token 耗时。这是用于组织测量的成本比,不是精确预测公式。接受率高也可能不够快,因为验证和草稿模型仍要执行。
部署前先把测量条件固定
先选目标模型、采样设置和真实请求长度分布,测量普通解码的首 token 延迟、生成阶段耗时与峰值显存,再在相同条件下加入草稿方案。记录平均接受长度、草稿时间、验证时间,并分别观察低并发与高并发;单请求加速不等于服务吞吐必然提高。
传统同 tokenizer 的模型组合更容易解释上述分布规则,但具体工具还可能支持不同 tokenizer 的对齐方式或自推测。Transformers v5.13.1 文档区分了这些路径,使用前需核对目标版本的模型、缓存和批处理限制,不把一种实现的支持范围推广到全部引擎。
缓存也要列入预算。使用独立草稿模型通常需要额外权重和运行状态;目标缓存则须跟随已经提交的前缀,处理拒绝后的状态。可结合KV cache 显存估算与PagedAttention 的分块管理理解:推测解码主要改变生成与验证流程,缓存分块主要改变存储管理,两者解决的问题不同。
参考资料
- Fast Inference from Transformers via Speculative Decoding:ICML 2023 已评审论文及原文 PDF。本文讨论已有算法,不作为最新新闻。
- Faster Assisted Generation with Dynamic Speculation:2024 年官方技术文章,动态长度机制与实验条件。
- Transformers v5.13.1 Assisted decoding:固定版本的辅助解码说明,具体接口和限制以实际安装版本为准。
支持
如果这篇文章对你有帮助,欢迎支持本站。



二维码可点击放大。更多支持方式见支持页面。