PagedAttention 如何管理 KV cache
长短请求混在一起时,大模型服务不仅要算得快,还要把显存分得合理。PagedAttention 让 KV cache 按块存放:同一段上下文在逻辑上连续,在显存里却可以分散。它解决的是缓存分配和复用问题,不会让每个 token 的 K、V 凭空变小。
为什么要给 KV cache 分块?
上一文KV cache 原理与显存估算讨论了缓存需要多少空间。这里换一个问题:请求还没生成完,我们并不知道它最后会有多长,该预留多少?
如果每个请求一开始就拿到按最大长度预留的连续区域,短回答也会占住暂时用不到的空间。不同大小的区域不断申请和释放,还可能留下难以利用的空隙。分块管理把容量切成相同规格的单元,请求增长时再取得新块,让空闲块可以服务其他请求。
这里比较的是一种按最大长度预留的方案,不代表所有推理框架都这样实现。分页也不是消除全部显存开销:末块空槽、块表和引擎自身的预留仍然存在。
块表把逻辑顺序映射到物理位置
设每个块容纳 4 个 token 的 KV 数据。一个已有 10 个缓存位置的序列需要 3 块:前两块填满,第三块用掉 2 个位置。块表可以是 [5, 1, 7],表示逻辑块 0、1、2 分别放在物理块 5、1、7 中。
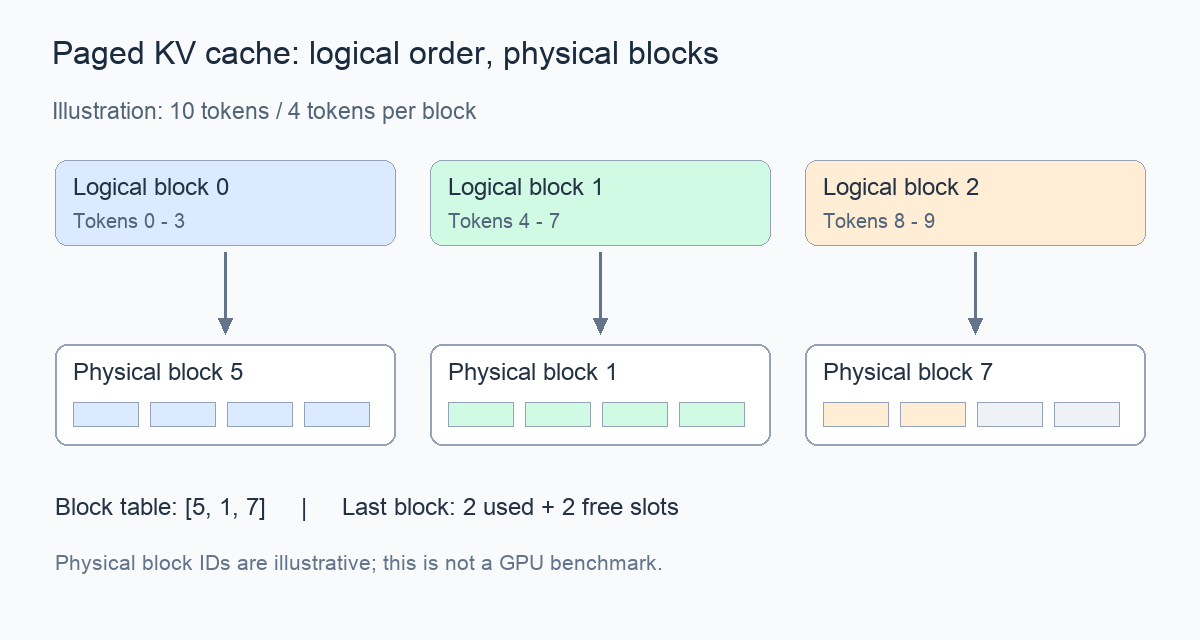
以从 0 开始的位置编号 t 为例,块容量为 b,先计算逻辑块号 t // b,再计算块内偏移 t % b。t = 9 时得到逻辑块 2、偏移 1;查询块表后,到物理块 7 的偏移 1 读取数据。注意力内核需要理解这种布局,不能仅把连续张量切开就期待原有内核自动兼容。
“Paged”借用了操作系统分页的思想。它并不等于把 KV cache 自动移到硬盘,也不意味着请求的全部历史都只读最后一块。对于完整因果注意力,计算仍需覆盖可见历史;分块改变的是数据存放和访问方式。
末块会浪费多少空间?
只考虑一个不共享的序列,每块容量为 b、已有缓存位置 T,则所需块数为 ceil(T / b),空槽数为 ceil(T / b) × b − T。T = 0 时不分配块;T 为正整数时,空槽数介于 0 和 b − 1。
这只是按 token 槽计数的模型。真实字节数还取决于层数、KV 头数、维度、数据精度和内存对齐。块越小,尾部空槽通常越少,但块表及访问管理更细;因此不存在仅凭这个公式就能选出的通用最佳块大小。
def block_layout(tokens, block_size):
    if tokens < 0 or block_size <= 0:
        raise ValueError('invalid size')
    blocks = (tokens + block_size - 1) // block_size
    return blocks, blocks * block_size - tokens

assert block_layout(0, 4) == (0, 0)
assert block_layout(8, 4) == (2, 0)
assert block_layout(10, 4) == (3, 2)
for n in range(100):
    b, unused = block_layout(n, 4)
    assert b * 4 >= n and 0 <= unused < 4
block_table = [5, 1, 7]
position = 9
logical, offset = divmod(position, 4)
assert (block_table[logical], offset) == (7, 1)
print('10 tokens:', block_layout(10, 4))
print('token 9 -> physical block', block_table[logical], 'offset', offset)
上面的纯 Python 示例已运行:检查了空序列、刚好填满和部分填满的情况,并验证 0 到 99 个 token 的空槽边界。输出如下:
10 tokens: (3, 2)
token 9 -> physical block 7 offset 1
这段代码验证的是容量计算和地址映射,没有执行注意力,也不是 vLLM 的内存分配器,更不能用来推断 GPU 加速比例。
前缀共享还有一个前提
分页为块级复用提供了基础。如果多个生成分支拥有同一段已计算前缀,可以把对应逻辑块指向相同物理块,并在需要修改共享数据时采用写时复制。实际能共享哪些块,取决于引擎、缓存键和边界处理。
相同的词并不足以证明缓存相同。KV 状态依赖模型和前面的上下文;相同 token 出现在不同上下文里,不能直接复用。服务端的前缀缓存策略也需要正确区分影响计算的输入条件。
| 优化方式 | 主要改变 | 不能直接推出 |
|---|---|---|
| PagedAttention | 分块布局、按需分配和块级共享基础 | 每个 token 的 KV 数据更小 |
| KV cache 量化 | 缓存数值的存储表示 | 完全没有精度或处理开销 |
| 前缀缓存 | 复用满足条件的已有前缀计算 | 任意相同文本片段都能命中 |
| 连续批处理 | 按迭代调度正在生成的请求 | 单请求延迟必然下降 |
看吞吐提升时,也要看请求形状
PagedAttention 的原始论文发表于 2023 年,并收录于 SOSP 2023;本文是机制说明,不是最新新闻。作者当时在指定模型与工作负载下报告了相对于 FasterTransformer 和 Orca 的吞吐改善。这是作者实验的结果,不能直接当作今天任意硬件和软件组合的性能承诺。
实际部署应同时记录模型与精度、推理引擎版本、输入和输出长度分布、并发、GPU 型号,以及首 token 延迟、逐 token 延迟和请求吞吐。尤其要避免用总 token 吞吐增长代替交互体验改善:批量容纳更多请求,和每个用户更早拿到答案,是不同指标。
如果瓶颈是缓存空间,分块管理值得检查;如果瓶颈在计算、带宽或排队,仍需结合执行内核和调度分析。部署的其他预算项可以参阅大语言模型部署与优化。
参考资料
- PagedAttention 原始论文:2023 年 9 月公开,论文页面标注 SOSP 2023 与正式 DOI;机制与实验需连同评测条件阅读。
- vLLM 项目介绍:分块、共享和写时复制的第一手说明。
- vLLM v0.18.0:Paged Attention 设计文档:具体内核的块布局与访问方式。固定版本用于解释实现,不代表当前版本的统一接口。
支持
如果这篇文章对你有帮助,欢迎支持本站。



二维码可点击放大。更多支持方式见支持页面。