RAG 混合检索:RRF 原理与实现
RAG 的关键词检索和向量检索,可能各自找对一部分材料,却给出难以直接比较的分数。RRF(倒数排名融合)用名次合并结果:先保留两路检索各自的排序,再把同一文档的排名贡献相加。它不需要把 BM25 分数和向量相似度硬凑到同一尺度。
为什么不直接把两路分数相加?
关键词检索擅长利用词项匹配信号,向量检索利用表示空间里的相似性。某一路得到 12 分,另一路得到 0.8,并不能仅凭数字大小判断谁更相关。直接相加会隐含一个尺度选择;归一化或训练融合是其他路线,RRF 则选择只看名次。
例如搜索具体错误码时,字面匹配可能很重要;换一种说法表达概念时,语义匹配可能有帮助。这是采用混合检索的动机,不是两路必然互补的保证,需要用真实查询验证。
RRF 的公式与一个小例子
对文档 d,RRF(d) = Σ 1 / (k + rankᵢ(d))。排名从 1 开始,只对包含该文档的列表求和;没被某一路召回,就没有那一路的贡献。k 是平滑常数,不是返回结果数。本例使用 k = 60。
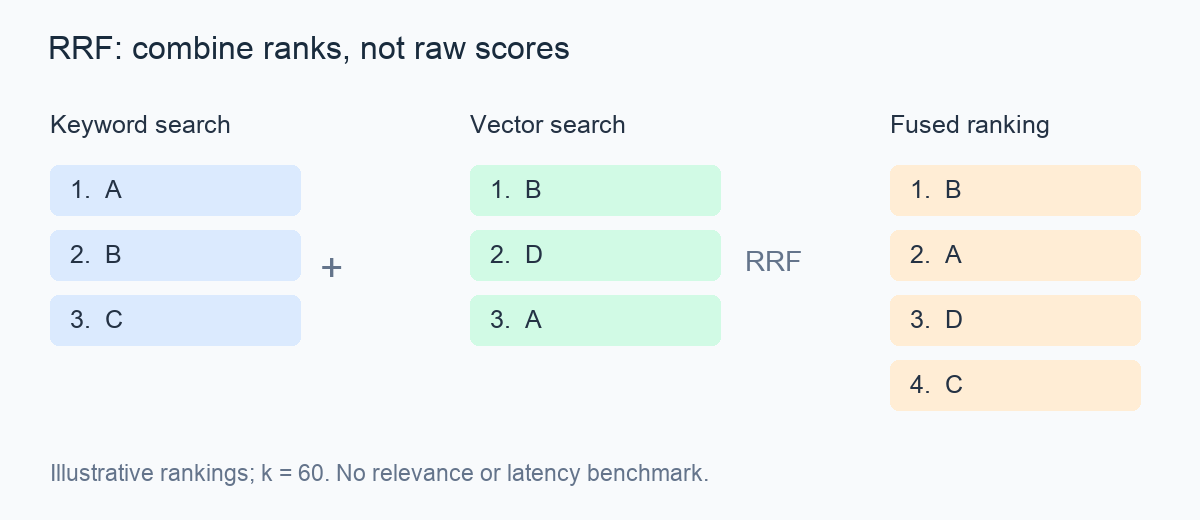
| 文档 | 关键词排名 | 向量排名 | 融合分数 |
|---|---|---|---|
| B | 2 | 1 | 1/62 + 1/61 ≈ 0.03252247 |
| A | 1 | 3 | 1/61 + 1/63 ≈ 0.03226646 |
| D | 未出现 | 2 | 1/62 ≈ 0.01612903 |
| C | 3 | 未出现 | 1/63 ≈ 0.01587302 |
B 在两路中都靠前,最终超过关键词列表第一名 A。这种跨列表支持并不证明 B 的内容正确;分数只是融合规则的产物,也不是答案正确概率。
用 Python 复算,而不是凭图判断
from collections import defaultdict
from fractions import Fraction

def rrf(lists, k=60):
    if k <= 0:
        raise ValueError('k must be positive')
    scores = defaultdict(Fraction)
    for ranked in lists:
        if len(set(ranked)) != len(ranked):
            raise ValueError('duplicate document ID in one list')
        for rank, doc in enumerate(ranked, 1):
            scores[doc] += Fraction(1, k + rank)
    return sorted(scores.items(), key=lambda x: (-x[1], x[0]))

results = rrf([['A', 'B', 'C'], ['B', 'D', 'A']])
assert [doc for doc, score in results] == ['B', 'A', 'D', 'C']
assert rrf([]) == []
assert rrf([['Z'], ['A']])[0][0] == 'A'
try:
    rrf([['A', 'A']])
except ValueError:
    pass
else:
    raise AssertionError('duplicates must be rejected')
for doc, score in results:
    print(doc, f'{float(score):.8f}')
代码已执行,输出与表格一致。它用分数做精确累加,只在展示时转为小数;同分时按文档 ID 排序,保证本例可复现。单路重复 ID 被拒绝,避免重复贡献;跨路相同 ID 正是需要融合的对象。空输入也已检查。
设输入名次总数为 N、不同文档数为 U。忽略数值运算位宽变化,字典累加平均 O(N),排序 O(U log U),额外空间 O(U)。这段代码没有运行关键词或向量检索,也不能说明真实系统的延迟。
候选窗口比公式更容易被忽略
每路只取前几个结果,就只有这些候选能进入融合。两路都没找到的文档,RRF 无法恢复。若融合后需要十条结果,却每路只检索极少候选,先检查召回窗口,再讨论排名常数。
增大 k 会缩小靠前与靠后名次之间的相对差异,不能将其当作“越大越准确”的旋钮。窗口大小、检索器质量及列表相关程度都会影响最终排序。Elastic 与 OpenSearch 的参数名称和限制属于各自产品接口,不能把示例函数当成其完整实现。
融合之后还要检查什么?
先统一文档或分块 ID:同一内容若在两路使用不同 ID,会被当成不同候选;不同内容若错误共用 ID,又会被错误合并。对检索结果做权限过滤,不能让融合把用户无权阅读的材料送入模型。
融合后可以再用适合任务的重排器,但它仍只能处理候选。保留检索相关性指标、答案引用是否支持论断,以及端到端延迟的分别测量。搜索质量变好,不等于模型一定忠实使用材料;引用也应对照原文检查。
RRF 面向检索,不改变生成阶段的 KV cache,可结合KV cache 原理与显存估算区分检索与生成的成本。English version。
参考资料
- RRF 原始论文,SIGIR 2009,本文讨论已有算法,不将其包装成新论文或最新新闻;原论文实验不作为本站性能承诺。
- Elastic:Reciprocal rank fusion,公式、排名起点与候选窗口的官方说明。
- OpenSearch:RRF,另一种产品实现的第一手文档。接口以实际使用版本为准。
补发说明:本文实际于2026年10月8日稍后补发,文章日期保留原计划的北京时间09:00。
支持
如果这篇文章对你有帮助,欢迎支持本站。



二维码可点击放大。更多支持方式见支持页面。