RAG 重排:Cross-Encoder 原理
RAG 找到了相关文档,答案却仍然偏题,问题可能出在前几条材料的顺序。Cross-Encoder 重排让问题与每个候选一起参与计算,再选择送入模型的材料。但它有一道明确的边界:没有进入候选池的证据,重排无法找回来。
这篇接着RRF 混合检索往下走:混合检索合并候选,重排检查这些候选与当前问题的匹配程度。English version
Cross-Encoder 放在哪里
一条常见流水线是:关键词检索与向量检索 → 候选合并、去重 → 重排 → 选取上下文 → 生成回答。第一阶段负责从较大的集合中找材料;第二阶段只处理候选池,避免对全部文档逐一进行昂贵的配对计算。
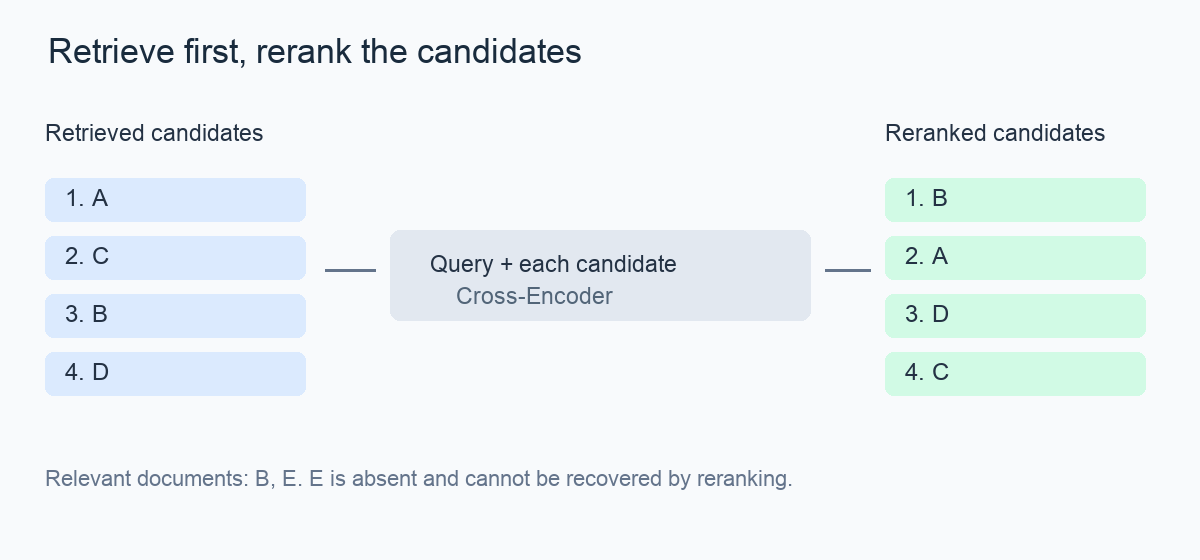
标准文本 Bi-Encoder 分别编码问题与文档,可以预先保存文档向量。Cross-Encoder 则联合处理问题和候选文本,让它们在同一次计算中交互。它产生配对分数,不能直接用一个与问题无关的文档向量代替这次配对计算。
分数不是正确率
将候选 d 对问题 q 的分数记为 s(q,d),按分数降序排列即可。这个分数是否落在 0 到 1,取决于模型与输出处理方式。Sentence Transformers 的使用文档明确指出,部分 MS MARCO 模型返回 logits。
即使给输出加 sigmoid,把数值压到 0 到 1,也不能直接解释成“这段材料有 90% 的概率正确”。单调变换可以保留顺序;概率解释还需要校准与相应评估。不同模型的原始分数也不宜直接混合比较。
排序改善,召回不变
设相关材料是 B、E,检索只得到 A、C、B、D。若重排将 B 移到第一位,读者或生成模型更早遇到有用证据;但 E 仍然缺失。
| 指标 | 重排前 | 重排后 |
|---|---|---|
| 候选池召回率 | 1/2 | 1/2 |
| 首条相关结果的位置 | 3 | 1 |
| 单个问题的倒数排名 RR | 1/3 | 1 |
这里 RR = 1 / 首条相关结果的排名;没有相关结果时记为 0。MRR 是多个问题的 RR 平均值,这张表只有一个问题,不能把它当成系统基准。候选池召回率则是候选中相关材料数量除以全部已标注相关材料数量。
下面的 Python 示例已经执行,并通过断言验证排序和指标。分数是人工构造的,没有调用模型,因此它只能验证逻辑,不能证明重排模型的实际效果。
def reciprocal_rank(order, relevant):
    return next((1 / rank for rank, doc in enumerate(order, 1)
                 if doc in relevant), 0.0)

def recall(order, relevant):
    if not relevant:
        raise ValueError('relevance labels are required')
    return len(set(order) & relevant) / len(relevant)

candidates = ['A', 'C', 'B', 'D']
relevant = {'B', 'E'}
# Invented scores illustrate ordering, not model predictions.
scores = {'A': 0.6, 'C': 0.1, 'B': 0.9, 'D': 0.3}
reranked = sorted(candidates, key=lambda d: (-scores[d], d))
assert set(reranked) == set(candidates)
assert reranked == ['B', 'A', 'D', 'C']
assert recall(candidates, relevant) == recall(reranked, relevant) == 0.5
assert reciprocal_rank(candidates, relevant) == 1 / 3
assert reciprocal_rank(reranked, relevant) == 1.0
assert reciprocal_rank([], relevant) == 0.0
print('order:', reranked)
print('candidate recall:', recall(reranked, relevant))
print('RR before / after:', reciprocal_rank(candidates, relevant),
      reciprocal_rank(reranked, relevant))
输出顺序为 B、A、D、C;候选池召回率保持 0.5,RR 从约 0.3333 变为 1。若只保留前一条,最终上下文的质量和覆盖率需要另算,不能沿用整个候选池的指标。
候选数量怎样选
候选池扩大,可能增加找到缺失证据的机会,也会增加配对数量。选择送入生成模型的条数是另一个参数:重排 50 条、最终保留 5 条,并不意味着两步都使用 top-5。
50 和 5 只是实验起点,不是通用配置。可以在自己的查询集上比较多个候选规模,记录候选召回、最终排序质量、端到端延迟和资源消耗。批处理可能提高吞吐,但实际收益取决于模型、硬件、文本长度和并发。
长文档尤其要检查截断。关键句如果落在被截掉的部分,候选虽被找到了,重排也可能看不到证据。分块、保留标题和必要的相邻语境,通常比直接把整篇长文交给固定长度输入更容易定位问题。
上线前看哪些失败
先把失败拆开:证据没有召回;证据在候选池却排得太后;选中的材料互相重复;材料已经足够但生成回答没有引用好。只有第二类直接对应排序问题。重排也不能自动验证文档里的事实,更不能替代权限过滤。
用有相关性标注、覆盖真实语言与领域的查询集,对比同一候选池“重排前”和“重排后”的结果,避免把检索策略变化误算成重排收益。同时记录尾部延迟与失败率,预先确定超时回退策略,例如返回原始候选顺序,并对回退结果单独统计。
如果相关材料始终没进池,应先检查检索、分块和查询表达。如果它已经在池中,却经常被无关段落挤出上下文,再考虑重排。这比仅凭最终回答好不好来判断模型更容易找到瓶颈。
参考资料
补发说明:本文于北京时间2026年10月8日补发,文章日期保留原计划14:00。示例为原创教学数据;未进行真实模型性能测试。
支持
如果这篇文章对你有帮助,欢迎支持本站。



二维码可点击放大。更多支持方式见支持页面。